Google DeepMind가 10월 28일 Gemini 4 Carbon을 발표했다. 코드 작성과 여러 단계의 작업을 수행하는 범용 AI 모델로, 오래 걸리는 소프트웨어 문제 해결과 보안 결함 수정에 초점을 맞췄다. 초기 접근은 일부 보안 담당 조직으로 제한한다. 공식 발표
보안 수정에서는 의심스러운 코드를 찾은 뒤, 수정이 실제로 문제를 막는지와 원래 기능을 유지하는지까지 확인해야 한다. 위 그림은 이 과정을 공개 평가 과제에 맞춰 정리한 예시다.
긴 작업을 이어가는 AI 모델
Carbon은 앞서 공개한 Gemini 4 Argon을 잇는 모델이다. Google은 내부 개발팀이 대규모 코드와 저수준 시스템의 복잡한 오류를 추적하면서, 막힌 접근을 바꿔가며 며칠 동안 작업한 사례를 소개했다. 회사의 내부 관찰로, 독립 검증된 평균 수행 시간과는 구분된다. 장기 소프트웨어 작업에 관한 설명
이런 작업을 맡기는 시스템을 에이전트라고 부른다. 모델이 코드를 읽고 다음 행동을 정하면 연결된 도구가 파일을 열거나 검사를 실행한다. 그 결과를 다시 읽고 수정 방향을 바꾸는 과정이 반복된다. 모델의 답변 능력과 함께, 어떤 자료와 실행 도구를 연결했는지가 작업 결과에 영향을 준다. 공식 평가도 모델마다 연결 도구와 실행 환경을 명시한다. 평가 환경과 실행 방식
예를 들어 이미지 미리보기를 만드는 프로그램이 잘못된 입력을 받았을 때 중단되는 문제를 생각할 수 있다. 문자 처리만 고쳐도 일부 오류는 사라지지만, 뒤이은 계산에서 다른 문제가 남을 수 있다. 수정된 코드가 정상 이미지도 같은 결과로 처리하는지 함께 확인해야 한다. 이런 과제는 코드를 그럴듯하게 작성하는 능력보다, 입력부터 결과까지 원인을 따라가고 검사를 이어가는 능력을 요구한다. CWE-bench의 공개 이미지 디코더 과제
취약점 발견과 수정은 어떻게 평가했나?
Google은 보안 능력을 취약점 발견, 위험 확인, 원인 수정으로 나눠 발표했다. 그중 SEC-bench Pro 결과는 아래와 같다. 점수는 Google이 공개한 평가이며, 다른 회사 모델의 값은 해당 회사가 발표한 결과에서 가져왔다. 수치의 출처와 평가 조건
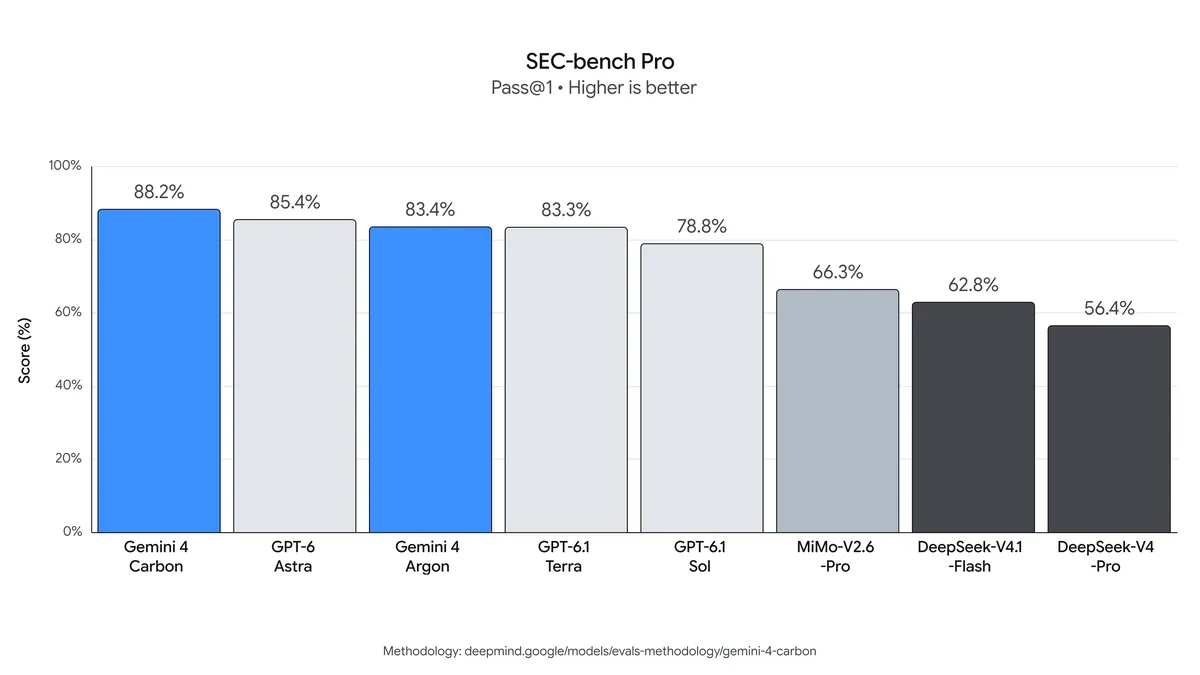
Carbon은 88.2%로 Argon보다 4.8%포인트 높았다. 이 비교는 2026년 5월의 자바스크립트 엔진 과제 183개를 대상으로 한다. 취약한 버전과 수정된 버전의 동작을 비교해 취약점 재현 여부를 판단하며, 과제별 단일 시도 평가를 독립적으로 세 번 반복해 평균을 냈다. 안전 필터를 해제한 평가여서 실제 서비스의 거부 정책이 적용된 결과와도 구분해야 한다. SEC-bench Pro 세부 방법 · 보안 평가 안내
평가 프로젝트의 현재 종합 순위는 V8·Firefox·Linux를 합친 344개 과제다. 따라서 그 화면의 점수를 위 183개 과제 결과와 바로 비교하면 안 된다. 과제 종류, 제한 시간, 에이전트 실행 환경이 같아야 모델 간 차이를 해석할 수 있다. SEC-bench Pro의 현재 평가 범위
실제 코드를 조사하고 고치는 능력은 Collinear AI의 CWE-bench에서도 확인할 수 있다. 10월 28일 공개 순위에서 Carbon의 프로그램 검사 기준 단일 실행 성공률(pass@1)은 71%이며 Argon과 GPT-6 Astra는 각각 68%다. 이 점수는 문제를 설명하는 답변이 아니라, 수정 후 취약점이 막히고 기존 검사가 통과하는지를 본 결과다. CWE-bench v1 순위
CWE-bench는 공개 소프트웨어를 바탕으로 한 비공개 평가 과제 120개를 사용한다. 각 모델을 높은 추론 설정으로 과제당 네 번 실행하고, 한 번의 실행에는 한 시간 제한을 둔다. 위 수치는 네 번 중 하나라도 성공한 비율(pass@4)이 아닌, 한 번의 실행을 기준으로 한 성공률이다. 모델마다 사용하는 에이전트 환경도 다르므로, 3%포인트 차이를 모든 코드 수정에서의 우위로 넓혀 해석하기는 어렵다. 평가와 채점 방식
현재 누가 이용할 수 있나?
Carbon은 발표와 동시에 누구나 선택할 수 있는 모델로 풀리지는 않았다. Google은 일부 보안 방어 조직부터 제공하고, Fairwind Program의 신뢰할 수 있는 파트너로 접근을 넓힌다고 밝혔다. 개발자·기업·일반 소비자용 제품 제공은 앞으로의 계획이다. 제공 일정
Fairwind는 정부, 의료·통신 같은 핵심 기반시설 운영 조직과 주요 기술 플랫폼 등을 우선하는 프로그램이다. 신청 조직의 보안 이력과 연구 활동을 검토하며, 참여 조직은 내부 보안팀의 접근을 관리해야 한다. 접근 권한의 재판매나 재배포도 허용하지 않는다. 프로그램 페이지의 기술 설명은 아직 Argon 중심이므로, 참여 자격이 곧 Carbon 이용 확정을 뜻하는 것은 아니다. Fairwind 참여 조건
이용을 검토하는 조직은 Google Cloud 담당팀을 통해 신청할 수 있다. 보안 평가 점수만으로 도입 여부를 정하기보다는, 자신의 코드와 검사 체계에서 수정 품질을 확인할 수 있는지도 살펴야 한다. 특히 코드가 실행되는 환경과 접근 가능한 저장소를 정하고, 실패한 검사와 남은 문제를 담당자가 볼 수 있어야 한다. 신청과 접근 관리 안내
발표한 도입 가격은 100만 토큰당 입력 2달러·출력 10달러이며, 도입 기간 뒤에는 각각 4달러·20달러가 적용된다. 토큰은 모델이 글과 코드를 처리하는 단위다. 긴 작업에서는 요청과 생성이 반복되므로 단가와 별도로 전체 사용량도 확인해야 한다. 도입 가격과 이후 가격
답글 남기기
댓글을 달기 위해서는 로그인해야합니다.