마이크로소프트가 10월 12일 Azure Maia 300을 공개했다. AI가 질문을 읽고 답을 생성하는 ‘추론’을 처리하는 데이터센터용 가속기다. 새로운 챗봇이나 AI 모델이 아니라, 모델을 실행하는 칩과 서버·네트워크를 함께 설계한 시스템이다. 현재 운영 중인 Maia 200의 후속 세대로, 실제 서비스 배치는 2027년에 시작할 예정이다. 공식 발표
영상은 하나의 칩이 서버와 랙 시스템의 일부가 되는 구성을 보여준다. Maia 300은 계산용 칩뿐 아니라 데이터 연결과 냉각까지 함께 설계해, 같은 전력으로 처리할 수 있는 AI 작업량을 늘리는 데 초점을 맞췄다.
긴 대화와 여러 단계의 AI 작업을 위한 설계
생성형 AI는 답을 한 번에 완성하지 않고 작은 단위인 토큰을 차례로 만든다. 이때 모델이 학습한 수치와 앞서 읽은 문맥에 관한 데이터를 계속 참고한다. 모델이 크고 대화가 길어질수록 계산 능력뿐 아니라 필요한 데이터를 메모리에서 얼마나 빨리 가져오는지가 중요해진다. 마이크로소프트는 Maia 300을 긴 문맥, 추론 과정이 긴 작업, 답을 연속으로 생성하는 작업에 맞춰 설계했다고 설명한다. 설계 목표와 내부 구조
예를 들어 AI 코딩 도구는 소스 파일을 읽고, 수정안을 만들고, 도구의 실행 결과를 받은 뒤 다시 코드를 고친다. 단계마다 자료를 읽고 새 토큰을 생성하므로 한 번의 짧은 답변과는 부하가 다르다. 여러 사용자가 이런 작업을 동시에 맡길 때, 개별 답변 속도와 서비스 전체가 감당할 수 있는 작업량을 함께 확보해야 한다.
이전 세대인 Maia 200은 이미 Microsoft Copilot 등 실제 서비스의 작업을 처리하고 있다. 마이크로소프트는 연말까지 GitHub Copilot과 Microsoft Foundry에도 적용할 계획이라고 밝혔다. Maia 300은 이 운영 경험을 바탕으로 확장하는 다음 시스템이며, 모든 서비스가 지금 새 칩으로 전환됐다는 뜻은 아니다. 현재 운영과 적용 계획
데이터 이동을 줄이고 여러 칩을 연결한다
핵심 원리는 소프트웨어가 데이터의 위치와 이동을 직접 조율하는 것이다. 계산 장치가 데이터를 기다리며 멈추는 시간을 줄이고, 멀리 옮기는 데 드는 에너지를 아끼려는 방식이다. 칩 안에는 자주 사용할 데이터를 잠시 두는 SRAM이 있고, 더 큰 저장 공간인 HBM에서 가져올 내용을 관리한다. HBM은 여러 층으로 쌓아 높은 대역폭을 확보하는 메모리다. Maia 데이터 흐름 설계
Maia 300은 계산 부분과 메모리 제어·입출력 부분을 작은 칩인 ‘칩렛’으로 나눈다. 계산 부분에는 TSMC N2P 공정을 쓰고, 서로 가까운 메모리를 활용하도록 설계했다. 가속기 하나의 HBM 용량은 288GB, 최대 대역폭은 초당 18TB다. 용량이 저장할 수 있는 양이라면 대역폭은 데이터를 옮길 수 있는 속도다. 큰 모델을 담을 수 있다는 것만으로 빠른 응답이 보장되지는 않는 이유다. 메모리와 칩렛 사양
연결된 가속기들은 입력 문맥을 먼저 처리하는 작업과 답을 생성하는 작업을 서로 다른 장치에 배치할 수 있다. 앞 단계에서 만든 문맥 정보를 같은 네트워크로 넘겨받아 이어서 처리한다. 이처럼 작업에 맞춰 계산·메모리·연결을 배분하는 설계가 추론 시스템의 효율을 좌우한다. 입력 처리와 답 생성의 분리
‘최대 7배’는 무엇을 비교한 수치인가?
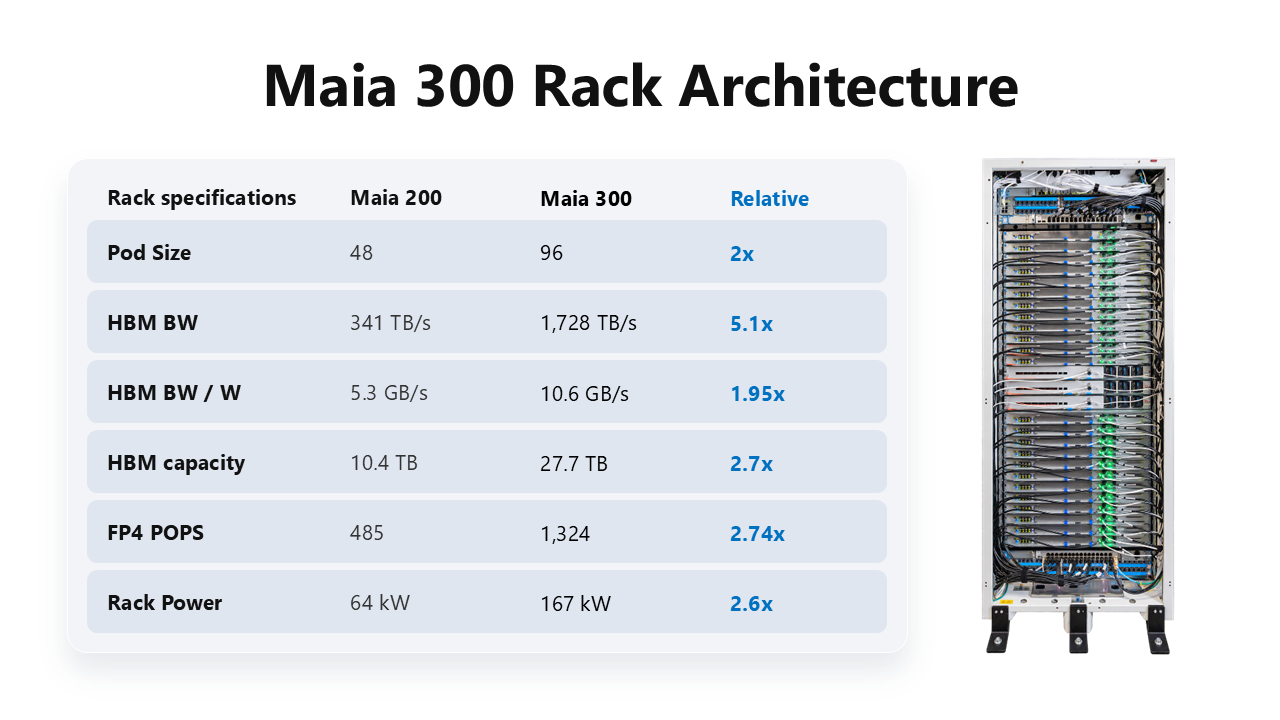
토큰 처리량은 일정 시간 동안 시스템 전체가 생성하는 양이다. 따라서 이 발표를 사용자 한 명의 답변이 7배 빨라지거나, AI가 7배 더 정확해진다는 의미로 읽으면 안 된다. 더 많은 장치를 넣은 랙의 처리량과 전력 효율을 구분해야 한다. 마이크로소프트는 별도로 Maia 200 대비 전력당 성능이 2.5배 이상이라고 설명하지만, 회사 발표 수치이며 공개된 작업별 재현 평가와는 다르다. 비교 범위
주요 GPU 기반 시스템보다 메가와트당 토큰을 40% 더 처리할 것으로 예상한다는 설명도 있다. 이는 아직 배치 전인 Maia 300의 예상치이며, 비교 GPU와 구체적인 실행 조건이 명시되지 않았다. 전력 효율 개선이 서비스 용량 확대에 도움이 될 수는 있지만, 이용 요금 인하나 특정 모델의 품질 향상으로 바로 환산할 수는 없다. GPU 대비 예상 효율
지금 사용할 수 있나?
Maia 300의 생산 배치는 2027년부터다. 이번 발표는 Microsoft 제품과 Azure 서비스의 기반 시설 계획으로, 개인이 칩을 사거나 Maia 300을 지정해 쓰는 공개 구매·API 절차와 가격은 안내하지 않았다. 기기 안에서 AI를 실행하는 DGX Spark와 달리, 사용자는 지원 서비스에 접속하는 방식으로 이 데이터센터 인프라의 영향을 받게 된다.
마이크로소프트는 2027년부터 Maia를 여러 기가와트 규모로 확대하고 자사 제품·서비스의 주요 추론 시스템으로 삼겠다고 밝혔다. 기가와트는 전력 규모를 나타내며 단일 칩의 소비 전력이 아니다. 어느 지역에서 어떤 서비스에 먼저 적용되는지와 실제 작업별 효율은 후속 공개를 확인해야 한다. 회사는 11월 Microsoft Ignite에서 AI 전략과 기술 도입에 관한 추가 정보를 공유할 계획이다. 배치 일정과 후속 발표
답글 남기기
댓글을 달기 위해서는 로그인해야합니다.