NVIDIA가 10월 15일 공개한 Nemotron 3.5 Super VL은 글과 이미지·영상을 함께 이해하고 도구를 쓰는 공개 AI 모델이다. GPU와 AI 소프트웨어를 만드는 NVIDIA가 기업의 문서 분석과 여러 단계의 업무를 위해 개발했다. 보고서의 차트를 읽고, 다른 페이지의 표와 연결해 답을 정리하는 일을 한 모델에 맡길 수 있다. 공식 발표
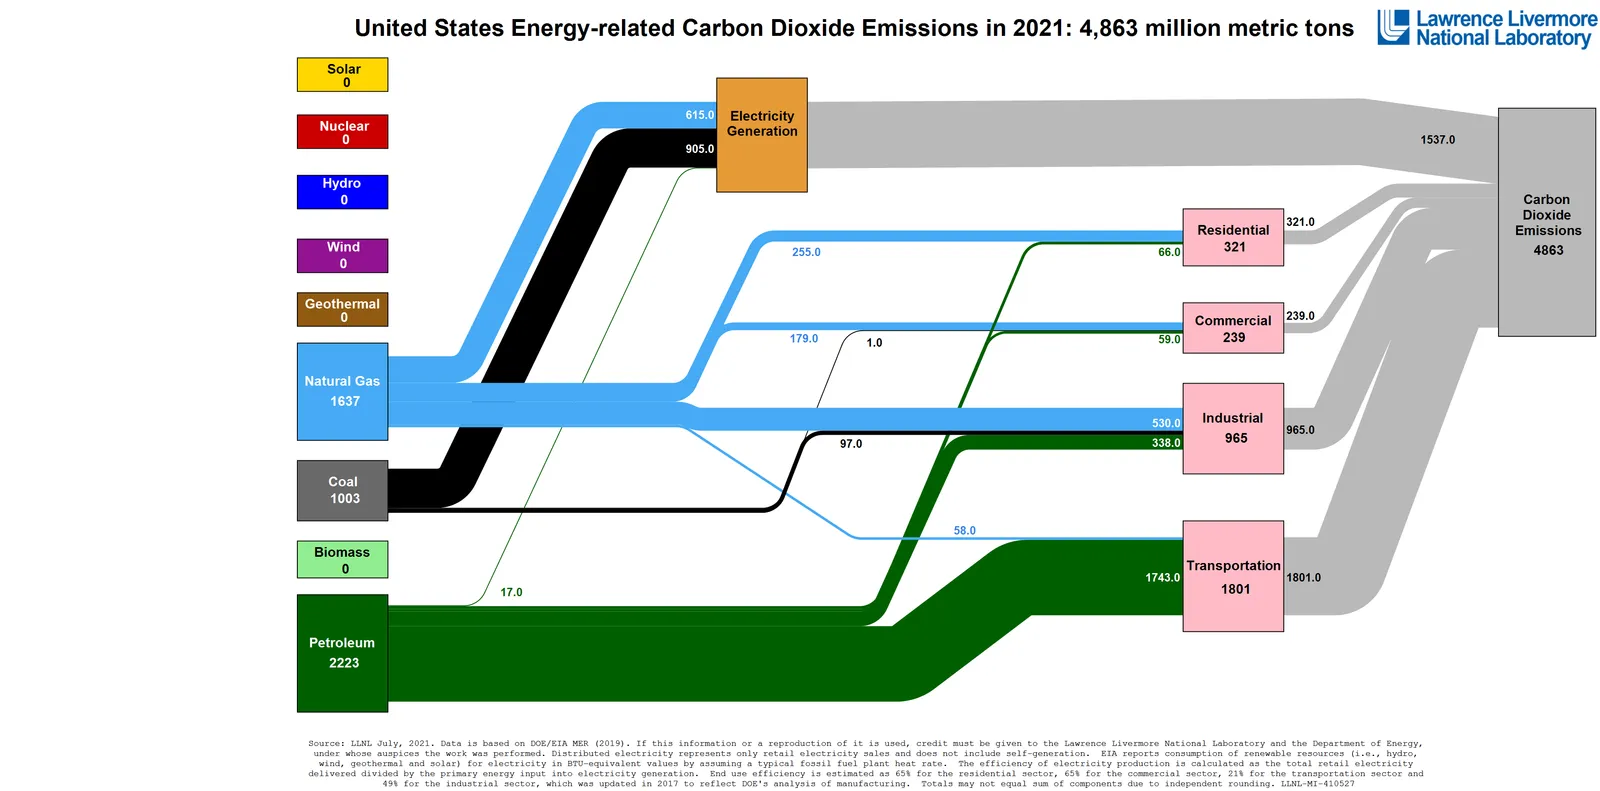
위 예시는 그림 속 단어만 읽는 것과 차트를 이해하는 것의 차이를 보여준다. 질문에 답하려면 산업 부문에 닿는 선을 찾고, 연결된 배출원과 값을 비교해야 한다. NVIDIA는 이런 시각적 근거를 따라 답하는 능력을 학습시켰다고 설명한다. 차트 이해 방식
문서에서 읽은 정보를 업무로 연결한다
Super VL은 개발자가 앱에 연결하는 모델이다. 완성된 회계 프로그램이나 문서 관리 서비스가 함께 제공되는 것은 아니다. 입력은 글·이미지·영상이고 출력은 텍스트다. 문서는 페이지 이미지와 글을 함께 제공할 수 있으며, 영상도 프레임을 뽑아 처리한다. 음성 입력은 지원하지 않는다. 입출력과 배포 안내
예를 들어 경비 처리 앱에 붙이면 영수증 이미지에서 가맹점·날짜·결제 정보를 읽어 이름과 값을 짝지은 JSON 데이터로 정리할 수 있다. 회사가 소개한 Ramp의 활용 방향이 이 작업이다. 보고서에서는 그래프와 표의 내용을 모아 요약하고, 영상에서는 검색이나 사건 분석에 필요한 정보를 추출하는 식으로 쓸 수 있다. 공식 활용 사례
모델이 도구 호출을 제안하면 연결된 프로그램이 검색·계산 등을 실행하고 결과를 돌려준다. 앱은 이 과정을 이어 붙여 업무를 완성한다. 읽은 내용을 확인하고 다음 행동을 고르는 역할이 함께 필요하다. 앞서 소개한 Microsoft-Decision-1이 정해진 질문의 판단에 초점을 맞췄다면, Super VL은 시각 자료 해석과 문장 생성까지 맡는 모델이다.
큰 모델을 매번 전부 계산하지 않는다
전체 매개변수는 1,200억 개지만, 텍스트 조각 하나를 처리할 때 활성화하는 부분은 약 120억 개다. 매개변수는 학습한 정보를 담는 수치다. 여러 전문가 중 필요한 부분을 골라 계산하는 MoE 구조로, 전체 모델 용량을 유지하면서 계산량을 줄인다. 다만 활성 수치가 작다고 모델 전체를 저장할 메모리까지 120억 개 규모가 되는 것은 아니다. 구조와 모델 카드
이미지는 시각 인코더가 모델이 처리할 표현으로 바꾸고, 언어 모델이 글과 함께 해석한다. 언어 처리에는 Mamba-2와 어텐션을 결합했다. 문맥을 이어 저장하는 방식과 필요한 정보 사이의 관계를 살피는 방식을 함께 쓰는 구조다. 토큰은 글을 나눈 처리 단위다. 최대 약 100만 토큰의 문맥을 지원하지만, 질문·그림·대화 기록·도구 결과·답변이 그 공간을 나눠 쓴다. 실제 배포에서는 메모리에 맞춰 더 짧게 설정할 수 있다. 설계와 문맥 조건
응답 생성에는 다음 토큰 여러 개를 미리 제안하고 본 모델이 검증하는 MTP도 사용한다. 맞는 제안을 한 번에 채택하면 생성에 필요한 계산 단계를 줄일 수 있다. 매번 다시 보내는 지침과 대화 앞부분의 계산을 재사용하는 캐시도 반복 작업의 부담을 낮춘다. 생성과 캐시 설정
압축해도 같은 능력이 유지될까?
원본 BF16과 함께 메모리 요구를 낮춘 NVFP4 버전도 공개됐다. 양자화는 모델의 수치를 더 적은 비트로 표현하는 방법이다. NVIDIA는 압축 모델이 원본의 출력을 따라 배우도록 추가 학습해 정확도 손실을 줄였다. 아래 비교에서는 어떤 작업의 점수는 같고, 다른 작업은 차이가 남는다. 압축 방식과 평가
긴 문서 이해 점수가 같다고 모든 업무의 성능이 유지된다는 뜻은 아니다. 터미널 작업에서는 압축 버전이 5.9점 낮았다. 두 결과는 회사 자체 평가이며, 실제 한국어 문서나 사내 프로그램에서 얻을 정확도를 보장하지 않는다. 같은 모델 이름이라도 사용 버전과 평가 도구를 확인해야 한다.
발표의 ‘최대 5배’는 또 다른 비교다. NVIDIA가 제시한 그래프는 입력 10만 토큰 조건의 출력 속도와 종합 지능 지수를 함께 놓고, Inkling Small 대비 속도 차이를 표시한다. 문서를 보내고 첫 답을 기다리는 시간이나 업무 전체가 끝나는 시간이 모두 5배 단축된다는 뜻은 아니다. 공식 속도 비교 원본

지금 사용할 수 있는 방법과 조건
가중치는 Hugging Face에서 받을 수 있고, OpenRouter나 NVIDIA NIM을 통한 이용 경로도 있다. 자체 실행은 모델을 내부 환경에 둘 수 있다는 장점이 있지만, 저장 공간과 GPU 메모리·운영 비용은 필요하다. NVIDIA NIM은 추론 엔진과 검증된 설정을 묶은 배포 도구다. 지원 GPU와 정밀도별 구성을 확인한 뒤 앱에서 API로 호출한다. 제공 경로 · 실행 조건
모델은 OpenMDW 1.1 조건으로 상업·비상업 이용이 가능하며, NVIDIA의 API 시험 서비스에는 별도 약관이 적용된다. 공개 가중치 이용과 호스팅 API 이용료는 구분해야 한다. 회사 데이터로 추가 학습하는 레시피도 있지만, 공식 학습 문서는 Super 3.5에 사용한 SFT·강화학습 데이터와 일부 구성 요소가 아직 공개되지 않았다고 명시한다. 공개 모델을 받는 것과 학습 과정을 그대로 재현하는 것은 범위가 다르다. 이용 조건 · 학습 자료 공개 현황
답글 남기기
댓글을 달기 위해서는 로그인해야합니다.